
COSTOS OCULTOS DEL ENTRENAMIENTO
Amazon destruye libros raros para entrenar sus modelos de inteligencia artificial
Una investigación de 404 Media reveló que Amazon compra textos raros, les corta el lomo y los escanea para alimentar sus LLMs. La práctica expone el dilema entre la demanda insaciable de datos de entrenamiento y la preservación del patrimonio cultural.
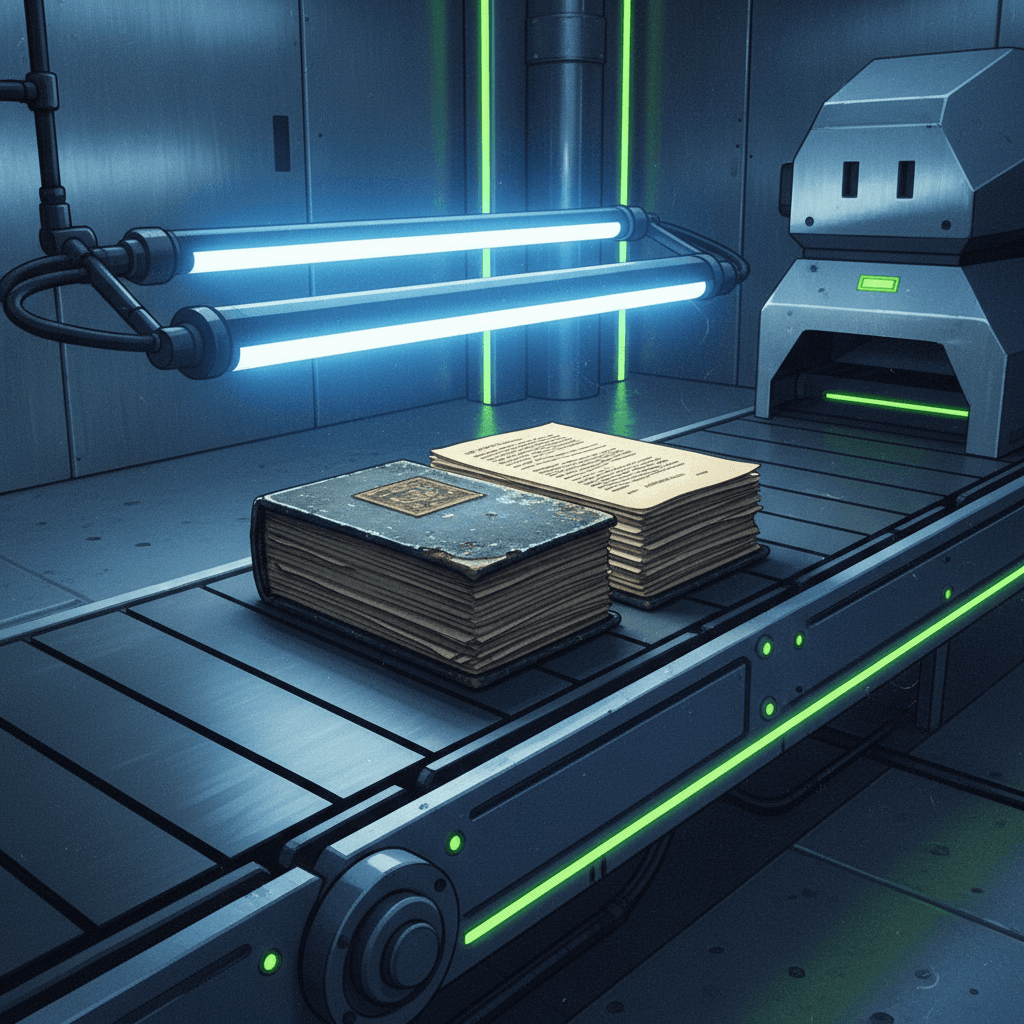
Amazon, la empresa que comenzó vendiendo libros online en 1994, ahora los está destruyendo para entrenar inteligencia artificial. Según una investigación de 404 Media, la compañía compra textos raros, les corta el lomo físicamente y los escanea en busca de datos de entrenamiento para sus modelos de lenguaje. Los periodistas confirmaron la práctica colocando un dispositivo de rastreo en un libro raro que terminó en una instalación de Amazon en Las Vegas identificada como VGT3, cuyo logo muestra un dinosaurio sosteniendo un libro entre sus garras.
La escasez de texto "limpio"
Las big tech enfrentan un problema creciente: ya agotaron gran parte del contenido disponible en internet para entrenar sus LLMs. Anthropic, por ejemplo, fue descubierta usando libros pirateados ilegalmente para alimentar Claude. Los textos raros, especialmente los descatalogados o imposibles de encontrar digitalizados, representan una nueva frontera de datos codiciados.
Estos materiales tienen una ventaja crucial: cualquier cosa publicada antes de 2022 garantiza que no fue generada por IA. Cuando los modelos de lenguaje entrenan con demasiado texto generado por otros LLMs, corren el riesgo de sufrir "model collapse", una degradación progresiva en la calidad de sus outputs.
En su declaración a 404 Media, Amazon confirmó que "compra libros a través de canales comerciales para mejorar los productos y servicios que usan nuestros clientes", sin especificar si esos libros sobreviven al proceso de escaneo.
El costo cultural de escalar IA
La ironía es brutal: la compañía que democratizó el acceso a libros ahora los convierte en combustible de entrenamiento desechable. No está claro si Amazon preserva copias digitales completas de estos textos raros o simplemente los procesa como materia prima para vectores de embeddings.
La práctica plantea preguntas incómodas sobre quién decide qué patrimonio cultural es prescindible en la carrera por datos de entrenamiento. A diferencia de las digitalizaciones de Google Books —que al menos dejaron copias accesibles—, esta operación parece tratada como logística industrial: comprar, cortar, escanear, descartar.
Por qué importa
Esta historia expone una tensión que recién empieza: la cantidad de texto "virgen" en el mundo es finita, y las empresas de IA ya están compitiendo por las últimas reservas no contaminadas. El hambre de datos de los LLMs está generando externalidades que van más allá de lo legal o lo técnico —ahora tocan lo patrimonial.
Para cualquier empresa construyendo sobre modelos fundacionales de terceros, vale preguntarse qué prácticas de adquisición de datos están financiando indirectamente. Y para quienes están armando pipelines propios de entrenamiento, el caso Amazon es un recordatorio: la escala no justifica cualquier medio, y eventualmente alguien va a rastrear de dónde salieron esos datos. La transparencia en la procedencia del entrenamiento no es solo una cuestión ética —es un riesgo reputacional medible.
// FUENTES
SEGUIR LA SEÑAL
VER TODO →
El Departamento de Justicia de EE.UU. respalda el uso justo en entrenamiento de IA
En la demanda del New York Times contra OpenAI y Microsoft, el DOJ argumenta que entrenar modelos con material protegido es uso justo. La distinción clave: copiar para entrenar no es lo mismo que el output del modelo.
Sony demanda a Anthropic por piratería masiva de letras y partituras musicales
Sellos como Sony, EMI y Warner acusan a Anthropic de descargar ilegalmente miles de composiciones vía torrents. Chats internos revelan que empleados celebraron el acceso a bibliotecas piratas como Z-Library.
Estados Unidos bloquea drones y robots chinos, pero la escala jugará a favor de Beijing
Washington impuso aranceles y restricciones a drones y robots extranjeros por seguridad nacional. El problema: China fabrica el 86% de los humanoides del mundo y puede vender en el resto del planeta mientras EE.UU. recién empieza a escalar.