
DATOS DE ENTRENAMIENTO
Empresas de IA destruyen libros raros para entrenar sus modelos
Un reporte expone cómo compañías de inteligencia artificial compran libros únicos, los escanean cortándoles el lomo y destruyen los originales. Un juez federal avaló la práctica. Textos que sobrevivieron siglos terminan triturados para datasets.
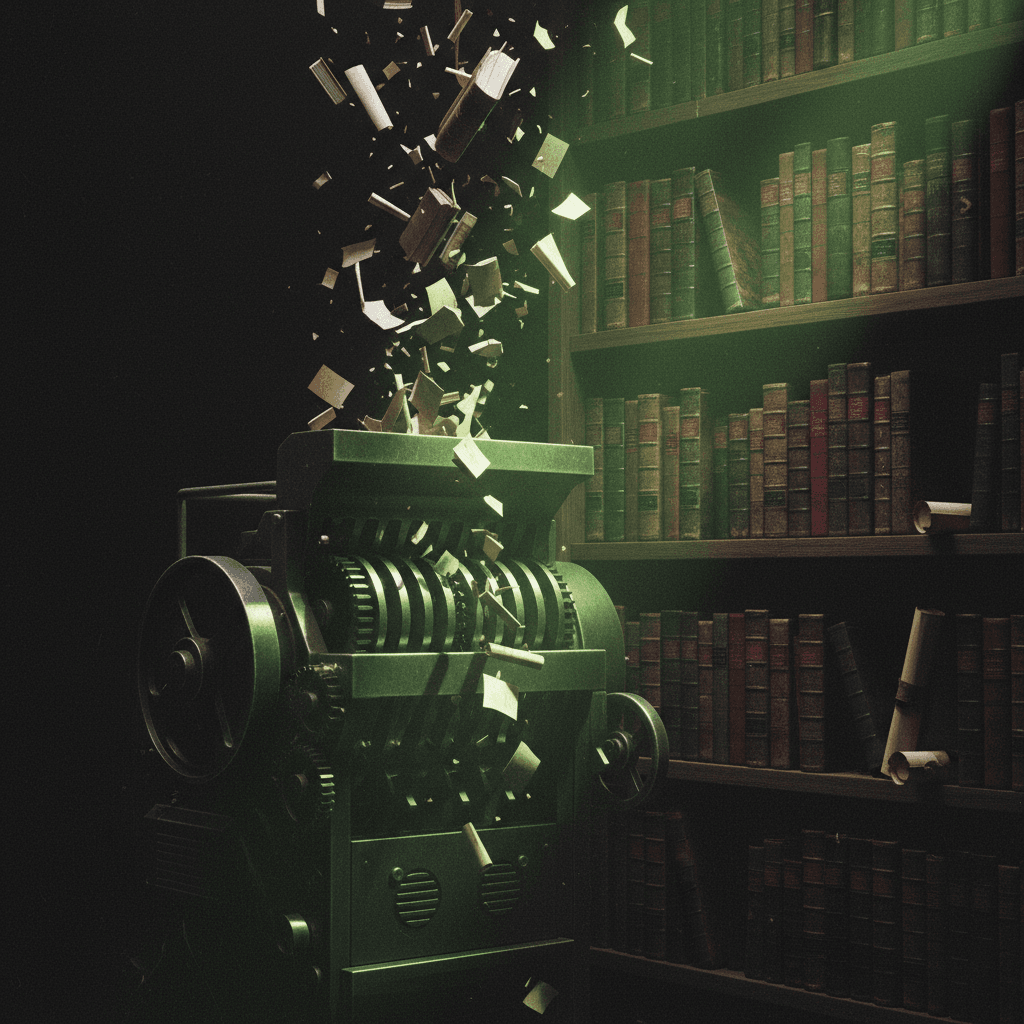
Empresas de inteligencia artificial están comprando libros raros en lotes masivos, escaneándolos con máquinas industriales que les cortan el lomo, y destruyendo los originales después del proceso. Según publicó el usuario Hedgie en X, un servicio llamado ISBNdb facilita pedidos de hasta un millón de libros manteniendo el anonimato de los compradores. Un juez federal de Estados Unidos avaló la práctica como uso legítimo.
El negocio de la destrucción
ISBNdb opera como intermediario entre vendedores de libros y empresas de IA que necesitan material de entrenamiento. Según el reporte citado por Hedgie, el servicio ofrece acuerdos de confidencialidad como feature y asesora a sus clientes para que llamen al proceso "preservación digital". El propio sitio web de la compañía reconoce que "'Una empresa de IA destruye dos millones de libros' no es un titular que genere simpatía".
Los libros publicados antes de 2022 tienen valor premium porque están libres de texto generado por IA. Según información atribuida a 404 Media en el hilo original, libreros reportan que ejemplares raros con casi ninguna copia sobreviviente están entrando en este pipeline de destrucción. Textos que sobrevivieron guerras, incendios y siglos de manipulación terminan triturados para que un modelo aprenda a redactar emails de marketing.
La decisión judicial que lo permite
Un juez federal estadounidense determinó que la práctica constituye uso legítimo (fair use) bajo el argumento de que eliminar el original implica que solo existe una copia a la vez. La decisión legal abre la puerta a que el modelo de negocio escale sin restricciones.
Según el reporte, Anthropic contrató al ex jefe de partnerships de Google Books con el objetivo declarado de obtener "todos los libros del mundo". La compañía no es la única: múltiples empresas de IA están adoptando esta estrategia de adquisición masiva y destructiva de material impreso para datasets de entrenamiento.
Por qué importa
Esta práctica plantea un dilema ético distinto al scraping web o la piratería de contenido digital. La destrucción es irreversible. Podés volver a subir un sitio web, reimprimir un bestseller, pero no podés reemplazar las últimas tres copias de un texto botánico del siglo XVIII una vez que alguien las tritura para datos de entrenamiento.
Para empresas que están implementando IA, el caso expone las zonas grises de la cadena de suministro de datos. Los modelos que usás fueron entrenados con algo. Entender de dónde viene ese material y a qué costo —cultural, legal, ético— se obtuvo ya no es una pregunta abstracta. Es due diligence.
La legalidad de la práctica según el fallo judicial implica que va a acelerarse. "Destruimos libros raros y ofrecemos NDAs para que nadie se entere" es, literalmente, un modelo de negocio viable en 2026. El debate sobre los límites aceptables en la obtención de datos para IA recién empieza.
SEGUIR LA SEÑAL
VER TODO →
Cómo se construye un modelo de lenguaje por difusión: la alternativa a GPT
Un paper del Kuleshov Group describe paso a paso cómo funcionan los LLMs por difusión, la arquitectura que compite con los modelos autoregresivos y que ya usan Google, NVIDIA e Inception Labs en producción.
Google DeepMind presenta un co-científico de IA que diseña experimentos y opera equipos de laboratorio
El sistema Co-Scientist de Google DeepMind ya no solo genera hipótesis: ahora planifica experimentos, escribe código, controla equipamiento y redacta papers científicos. En pruebas de tres disciplinas logró 4% de alucinaciones, contra 90% de sistemas anteriores.
LAION lanza dataset de 10 millones de horas de video para entrenar modelos de IA
El dataset Big Video Dataset (BVD) contiene 55 millones de clips con descripciones de audio y video generadas automáticamente, más 300 millones de imágenes. Modelos entrenados con BVD superan a InternVid por hasta 2,1 puntos porcentuales.